- #WhaTap
-
 3分
- 2026.09.25
- 更新 2026.09.28
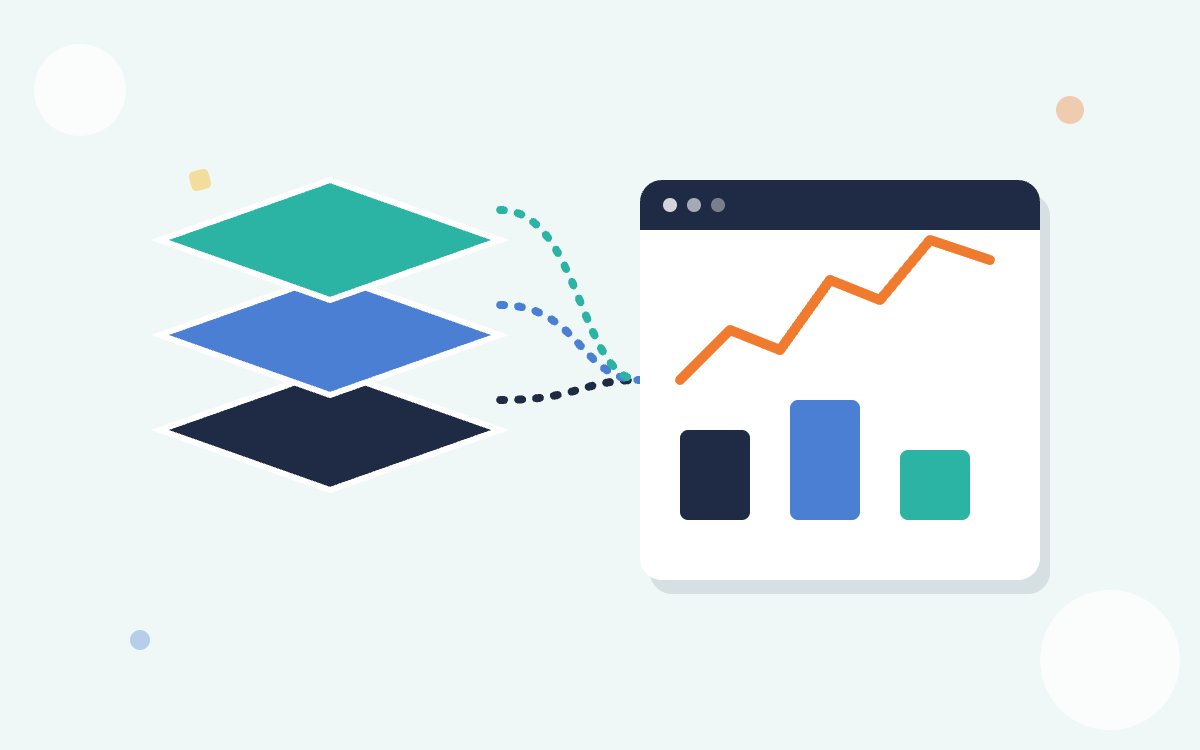
監視ツールを導入しているのに、障害時の原因特定に時間がかかる——その原因の多くは、インフラ・アプリ・DBを別々のツールで見ていることにあります。
本記事では、これらを一元的に監視する意義を、現場でよくある失敗パターンとあわせて解説します。
システム運用監視を担当するインフラ・情シス担当者向けの内容です。
監視ツールが分断されている
よくある失敗パターン:インフラ用・アプリ用・DB用のツールがバラバラで全体像が見えない
インフラ・アプリケーション・データベースをそれぞれ別のツールで監視していると、障害発生時に「どこに問題があるのか」を突き止めるまでに、複数のツールを行き来して確認する手間が発生します。
その間にも、担当者ごとに「自分の領域は問題ない」という報告が上がり、原因の切り分けにさらに時間がかかるケースも少なくありません。
インフラ担当は「サーバーのCPU使用率は正常」と言い、アプリ担当は「処理時間に異常はない」と言う——それぞれのツールで見ている範囲が違うだけで、実際はDBのロック待ちが原因だった、というすれ違いは典型的な例です。
一元的に見ることで分かること
| 監視対象 | 把握できること |
|---|---|
| インフラ | サーバーのCPU・メモリ・ディスクなどのリソース状況 |
| アプリケーション | 処理の遅延やエラーが、ユーザーにどう影響しているか |
| データベース | スロークエリやアクティブセッションの状況 |
これらを一つの画面で横断的に確認できると、「ユーザー影響が出ている処理」から逆算して、インフラ・アプリ・DBのどこに原因があるかをピンポイントで特定できるようになります。
統合監視への移行を後回しにする
よくある失敗パターン:「そのうち統合したい」と思いながら、既存ツールを使い続けてしまう
統合監視のメリット
- 障害対応のスピードが上がる:原因特定にかかる時間が大幅に短縮される
- 属人化を防げる:ツールが統一されていれば、担当者以外でも状況を把握しやすい
- 予兆の検知がしやすくなる:全体像が見えることで、障害が起きる前の異常にも気づきやすい
統合には一定の切り替えコストがかかりますが、障害対応のたびに発生している「原因特定の手間」を積み上げて考えると、早期に移行したほうがトータルでの負担は小さくなるケースがほとんどです。
まとめ
| 論点 | ポイント |
|---|---|
| 分断の問題 | ツールが別々だと原因特定に時間がかかる |
| 統合の効果 | 障害対応のスピードと属人化対策の両方に効く |
| 移行のコツ | 先延ばしにせず、早期の切り替えでトータルの負担を減らす |
インフラ・アプリ・DBを一元的に監視することは、単なる効率化ではなく、障害対応のスピードと組織全体の対応力を左右する重要な投資です。「監視はしているのに原因が分からない」という状態に心当たりがあれば、監視体制そのものを見直すタイミングかもしれません。